AI的分歧提示,开始成为有条件的打断

AI给出错误答案时,语言通常不会随准确程度发生明显变化。一条缺乏依据的结论,同样可以拥有完整的结构、流畅的表达和看似严密的解释。用户面对的困难不只是模型可能出错,还在于界面很少提供足够的线索,帮助人判断何时应该停止接受,转而核验。
一种常见的处理方式,是同时展示多个模型的回答。用户可以把同一个问题分别交给ChatGPT、Claude和Gemini,再从几份结果中寻找共同点与矛盾。这种方式增加了可供判断的信息,也把完整的比较工作交给了用户。大量差异可能只来自措辞、结构和详略程度,真正影响结论的冲突反而容易隐藏在数段相似文本之中。
9月27日正式公开发布的Cuey试图减少这部分比较成本。它以浏览器扩展的形式运行在ChatGPT、Claude和Gemini等产品中。当用户向当前模型提问时,Cuey会在后台把同一个问题交给另外三个模型,判断它们是否提供了当前回答缺失的重要信息。
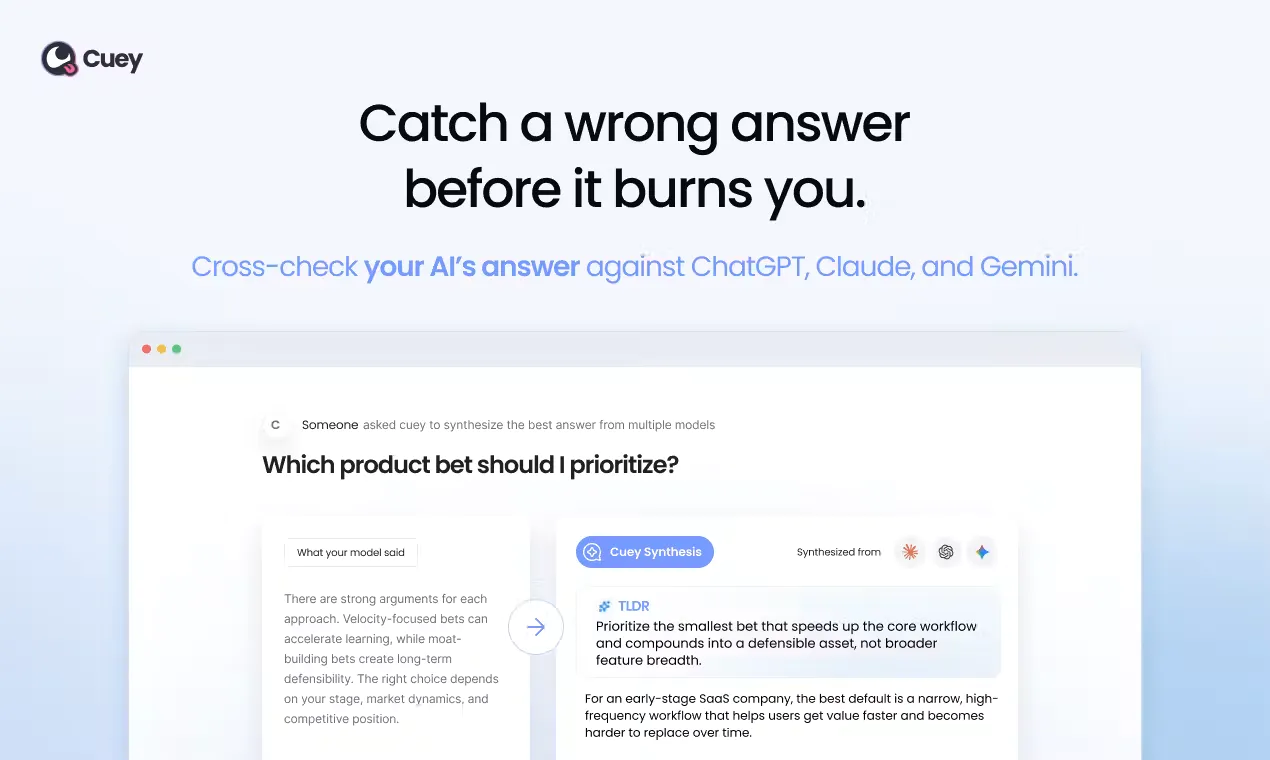
只有检测到所谓“有意义的差异”,系统才会发出通知,用户打开侧栏后才能看到具体比较。没有发现明显分歧时,原有对话不会被打断;如果用户对某个回答仍有疑虑,也可以手动启动比较。
Cuey没有改变模型的回答能力,改变的是不确定性进入界面的方式。置信度百分比把判断压缩成一个抽象数字,要求用户自行理解它与当前任务的关系;并排展示多份答案,则要求用户逐句寻找差异。Cuey把初步筛选留在后台,只在分歧可能影响决定时让它进入当前界面。
这种设计让提醒不再是一项附加信息,而成为对交互过程的主动干预。系统必须先区分哪些变化只是表达方式不同,哪些差异涉及事实、来源、假设或结论。如果几个模型只是调整了推荐顺序,未必需要中断当前工作;如果只有一个模型发现了关键限制,或者多份回答对核心事实给出相反判断,保持沉默便可能造成风险。
Cuey最重要的设计选择,同时也是它最难解决的问题:什么才算“有意义的差异”。
差异的重要程度并不是文本本身具有的固定属性,而取决于用户准备怎样使用答案。同一个数字出现在随手查询中,影响可能有限;一旦进入合同、研究报告或商业提案,即使细微偏差也可能改变后续决定。系统可以判断两段回答是否不同,却未必充分理解这种差异将在现实中产生多大后果。
提醒门槛过低,用户会不断被无关紧要的变化打断,最终习惯性地忽略通知;门槛过高,产品又可能延续AI回答原有的确定感,让用户把“没有出现分歧提示”理解为“当前结论已经得到验证”。界面需要处理的因而不只是是否提醒,还包括提醒将承担何种含义。
分歧出现以后,侧栏也不能只陈列更多文本。它需要说明差异发生在哪一层:是数据不一致、引用来源不同,还是模型基于相同事实形成了不同解释。只有把冲突定位清楚,用户才知道下一步应该补充信息、检查来源、修改问题,还是暂缓行动。
Cuey保留手动比较入口,正是对自动判断边界的一种补充。系统可以减少重复劳动,却不能替代用户对风险的理解。自动机制负责发现可能被忽略的信号,是否需要继续核验,仍应由用户根据任务后果决定。
产品目前也缺少足够的外部验证。Cuey在正式发布前已经运行三个多月,团队称扩展拥有约2000名用户,但公开资料尚未提供“有意义差异”的识别准确率,也没有说明误报和漏报的比例。多个模型达成一致同样不能证明答案正确,因为它们可能使用相近的训练资料、搜索来源与推理方式。
将问题和相关上下文发送给其他模型,还会引入新的隐私边界。用户可能愿意让当前模型读取一份文件,却未必意识到其中的信息也会进入其他服务。比较机制越自动,数据流向越需要在界面中得到明确说明。
Cuey把一个长期停留在原则层面的讨论转化为具体的交互问题:AI的不确定性不必持续占据屏幕,也不能只在后台留下一个难以解释的分数。设计需要决定哪一种分歧足以影响用户接下来的行动,并因此获得一次中断当前流程的权利。