“有品位”不能成为 AI 时代的设计评审标准

10 月 6 日,数据标注与 AI 评估公司 HumanSignal 公布了一项网站生成实验。公司创意总监 Todd Morey 让来自十家实验室的十个模型分别处理十份相同的客户 brief,内容包括远程医疗应用、纽约滑板服饰品牌等不同场景。模型需要自行确定字体、色彩、图像与页面结构,同时记录作出这些选择的理由。
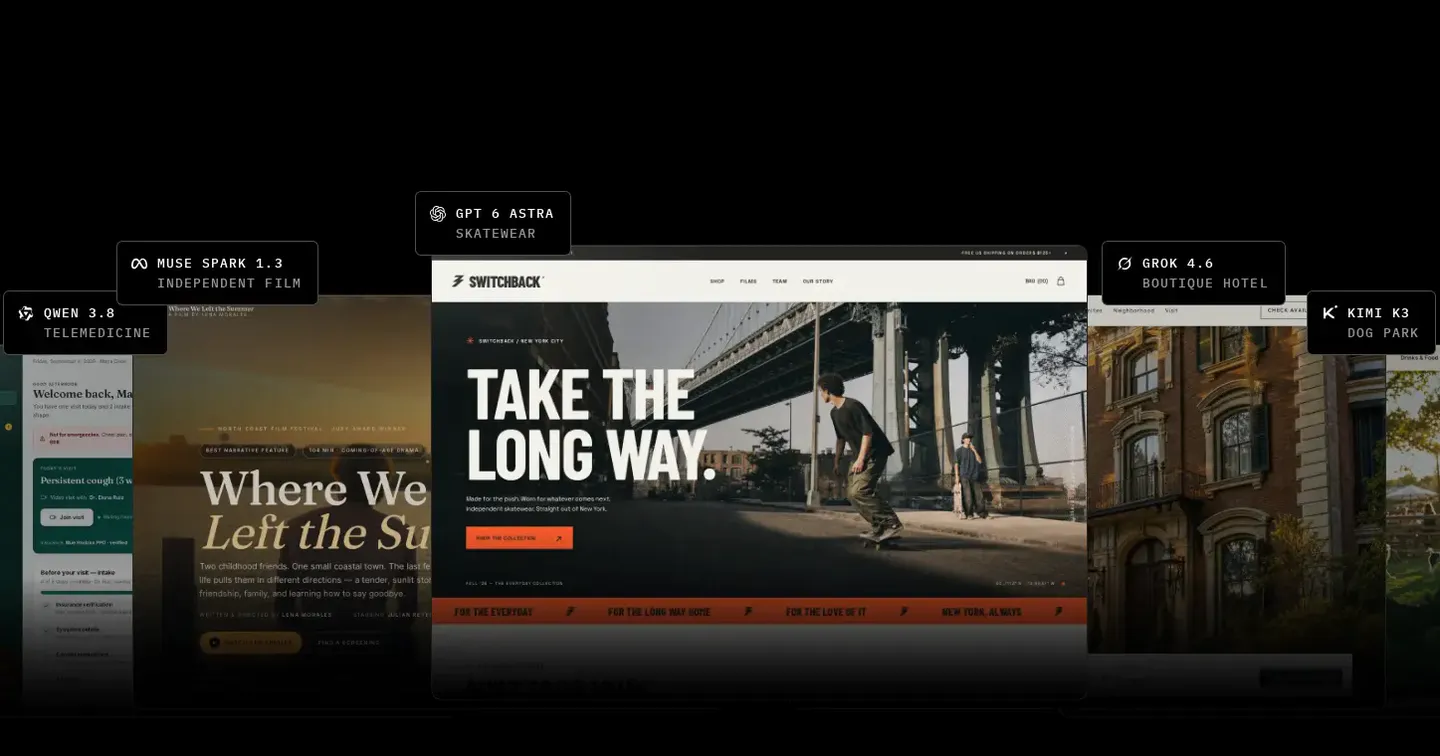
为了尽量排除工具条件造成的差异,实验让所有模型使用相同的运行环境和图像模型,禁止网页搜索,也不允许调用外部框架与组件库。每份 brief 又被拆成三个环节,分别观察模型如何提出创意方向、如何依据固定方向完成页面,以及如何独立完成从构思到实现的全过程。最终生成的一百个网站接受了盲测。29 名评审者完成 450 组两两比较,累计作出 4500 次选择。
模型来自不同实验室,做出的视觉决定却高度集中。Inter 出现在 47% 的字体系统中,91% 的网站使用渐变,88% 使用带阴影的卡片。面对远程医疗 brief,十个模型中有八个选择深青色作为主色,其中几个还把这一选择解释为对“常见医疗蓝”的回避。每个模型都试图表现差异,最后却共同形成了另一套可辨认的惯例。
这种趋同在页面被实现之前已经出现。模型只负责描述创意方向、尚未接触代码与组件库时,仍然会选择相似的字体、颜色和视觉语气。生成结果的共同风格因而不能完全归咎于某种前端框架。模型从训练资料中继承的不只是页面如何实现,也包括什么显得专业、克制、现代,以及什么通常会被理解为差异化。
1. 偏好不是适配
HumanSignal 的实验由此把设计生成的评价从“能不能完成”提升到“人是否喜欢”。传统测试可以检查页面是否响应、功能是否运行、结果是否接近参考设计,这些问题大多存在相对明确的答案。审美偏好没有同样稳定的判定方式。盲测能够降低模型品牌对选择的影响,也可以排列两项结果之间的相对偏好,却不能直接证明胜出的方案更适合产品。
一套远程医疗界面可能因为色彩克制而获得更多选择,但这种偏好无法说明它是否建立了正确的信息优先级,也无法证明关键状态足够清楚。滑板品牌网站可以因视觉张力而显得更鲜明,却未必准确回应实际受众、内容策略和使用场景。评审者选择了“更喜欢”的方案,团队仍然不知道这种喜欢来自字体、配色、构图、品牌联想,还是对某种熟悉风格的认可。
“有品位”作为评审标准的问题正在于此。它把多种性质不同的判断压缩成一个无法拆解的总评。字体是否易读、信息层级是否清楚、色彩是否符合品牌、页面是否忠于 brief、交互状态是否完整,都可能共同影响最终感受。一旦讨论止于“这个更好”,胜出的设计便只得到认可,没有获得可以被解释和复用的理由。
2. 评价维度拆解
TASTE 研究处理的是同一问题的另一个环节。该研究邀请十名专业设计师,对四款图像模型生成的内容进行评价。研究者没有只要求设计师选出更喜欢的结果,而是把判断拆成视觉层级、字体、色彩、空间关系、氛围与 brief 忠实度等九个维度。由此获得的不只是一个胜负结果,而是每项设计在哪些方面成立,又在哪些方面失效。
不同维度呈现出的共识程度并不相同。设计师对文字是否正确出现、色彩是否符合要求等可核查问题较容易取得一致;对色彩是否和谐、字体是否得当等依赖感受与经验的判断,分歧明显增加。设计评价并非完全主观,也不是一套可以机械执行的客观规则。它同时包含能够核验的条件、经过训练形成的专业判断,以及与具体语境有关的取舍。
研究团队还测试了九种视觉语言模型和审美评分系统,没有一种在总体上达到与五人设计师小组 55% 的一致率;一名专业设计师与小组多数意见的一致率约为 74.1%。扩大模型规模也没有带来稳定提升。现有系统欠缺的并非生成更多结果的能力,而是区分设计问题、理解评价维度,并判断这些维度在当前任务中应如何取舍的依据。
两项研究由此构成了一条连续的关系。HumanSignal 的研究证明,不同模型可能在缺少明确约束时共同滑向一套熟练的视觉答案;TASTE 的研究则说明,纠正这种趋同不能只依靠一个笼统的偏好分数。倘若评审者只告诉系统哪个结果更有品位,模型最容易学习到的是某种表面风格受到欢迎,而不是这种选择为何适合特定产品。
3. 直觉不是结论
经验丰富的设计师往往能够迅速察觉比例失衡、语气偏离或视觉关系松散,有些判断也很难在当下完整表述。直觉适合作为发现问题的入口,却不应成为讨论的终点。评审需要继续追问,不适感来自信息层级、内容密度、品牌关系还是交互预期;方案偏离的是个人习惯、行业惯例,还是产品必须遵守的条件。
这种追问并非为了把审美转换成僵硬的评分表,而是为了区分不同类型的判断。用户任务、内容准确性、信息层级、无障碍与状态完整性属于设计必须满足的条件;品牌语气、形式新意、视觉张力和情绪表达则需要结合场景权衡。前者不能被“看起来不错”代替,后者也不能被单一规则提前消除。评审的专业性体现在说明两者如何共同支持当前方案。
过去,团队面对的方案数量有限,含混判断还可能在后续协作中逐步澄清。生成工具可以持续提供新的成品,如果评审没有稳定维度,团队便会反复选择,却无法形成可以延续的设计知识。模型可能记住某位评审者偏爱的颜色和构图,但仍然不知道这些偏好在何种产品、用户与任务中有效。
HumanSignal 的实验只覆盖十份 brief 和一百个生成网站,29 名评审者的专业背景没有在文章中完整公开。这项材料来自企业内部实验,也不是经过同行评审的学术研究。TASTE 同样承认样本有限,研究内容全部使用英文,现有维度还没有覆盖无障碍、动效、品牌一致性和受众适配。两项研究都不足以建立一套普遍适用的设计评价体系,却共同说明了单一偏好判断会遗漏什么。
当生成速度远高于评审速度,“有品位”会成为一种过于便利的语言。它能够迅速结束争论,却不能让团队积累判断,也不能让模型理解自己的偏差。