Figma 让代码进入画布,设计评审开始面对真实行为

一套设计稿可以把页面组织得十分完整,却仍然无法回答使用过程中所有的问题。
用户输入超出预期的内容,中途改变选择,或者遇到等待和错误,都会使界面进入另一种状态。评审材料通常展示设计师预先选定的时刻,用户经历的却是这些时刻之间持续发生的变化。两者之间的差距,常常要到实现之后才充分显现。
2026 年 10 月 15 日,设计协作平台 Figma 在 Config India 期间将 Code Layers 推向公开测试。团队可以把代码驱动的交互原型放进 Figma Design 画布,与设计稿放在一起查看、操作和修改。这些原型既可以通过 AI 从现有设计生成,也可以导入已有代码,再由团队共同探索不同方向。
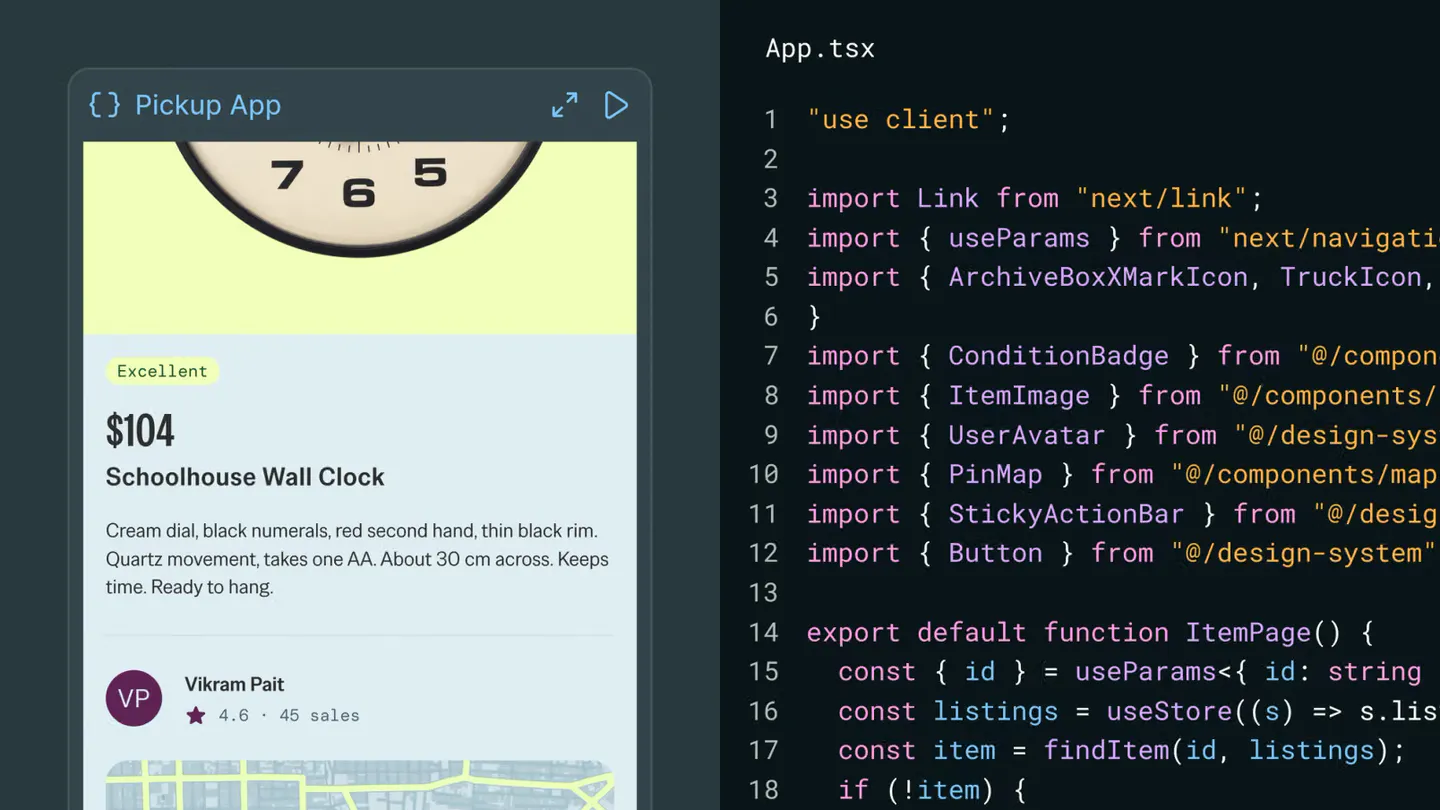
1. 在操作中比较
这种安排改变了评审能够检查的内容。以表单为例,静态稿可以清楚呈现字段顺序、标签位置和错误样式,却无法充分说明错误提示应在何时出现。用户尚未输入完毕,系统便开始报错,可能造成干扰;直到提交后才集中提示,又可能增加返工。只有让输入、校验和反馈实际发生,团队才能观察这些决定怎样影响操作节奏。
Code Layers 允许团队像复制设计稿一样复制代码原型,再把不同方案放在画布上并列运行。评审者可以完成同一项任务,比较两种反馈方式、两条操作路径或不同的信息组织。方案差异由此变得更容易讨论。某个流程步骤更少,却可能要求用户记住更多信息;另一种布局看起来紧凑,却可能在内容变长后失去层级。这些问题需要在连续操作中判断,单独查看几张页面很难得到充分答案。
评审也因此能够更早发现设计遗漏。等待期间是否允许重复提交,修改前面的选择后,后续内容是否随之更新,错误发生后用户能否保留已填写的信息,都需要明确处理。画面之间原先依靠说明连接的部分,都成为可以被检查的行为。
2. 追问行为的依据
不过,原型运行以后,新的问题随之出现。
AI 可以迅速补齐设计稿没有交代的细节,让流程显得顺畅完整。如果团队只要求生成一个注册页面,模型仍然需要决定校验时机、错误反馈、按钮状态和跳转条件。这些行为已经写进代码,却未必经过设计师确认。
评审因而需要追问,每项行为依据什么形成。哪些来自已经确定的业务规则,哪些沿用了现有产品,哪些只是生成过程中采用的默认安排。一个操作能够顺利完成,只能说明当前实现支持这条路径;它是否符合用户预期、是否覆盖必要条件,仍然需要证据。否则,原型的完成度越高,未经讨论的决定越容易被当作既定方案保留下来。
3. 原型仍需验证
代码来源同样决定了评审结论能够延伸多远。如果原型沿用现有产品的组件和逻辑,团队就有机会更早发现共用关系。一处控件修改可能影响多个流程,一项视觉调整也可能涉及既有状态。若原型使用独立生成的模拟逻辑,这些工程关系便未必存在,所以不能仅凭演示推断正式产品中的修改成本与影响范围。
Code Layers 目前仍处于公开测试阶段。Figma 表示,对更复杂代码库的支持还将继续扩展。团队可以用它提前观察行为、比较方向、发现遗漏,但真实数据、异常条件、无障碍要求和用户使用情况,仍需在相应环境中检验。